در حال بارگذاری صفحه...

جستجو در
Ctrl K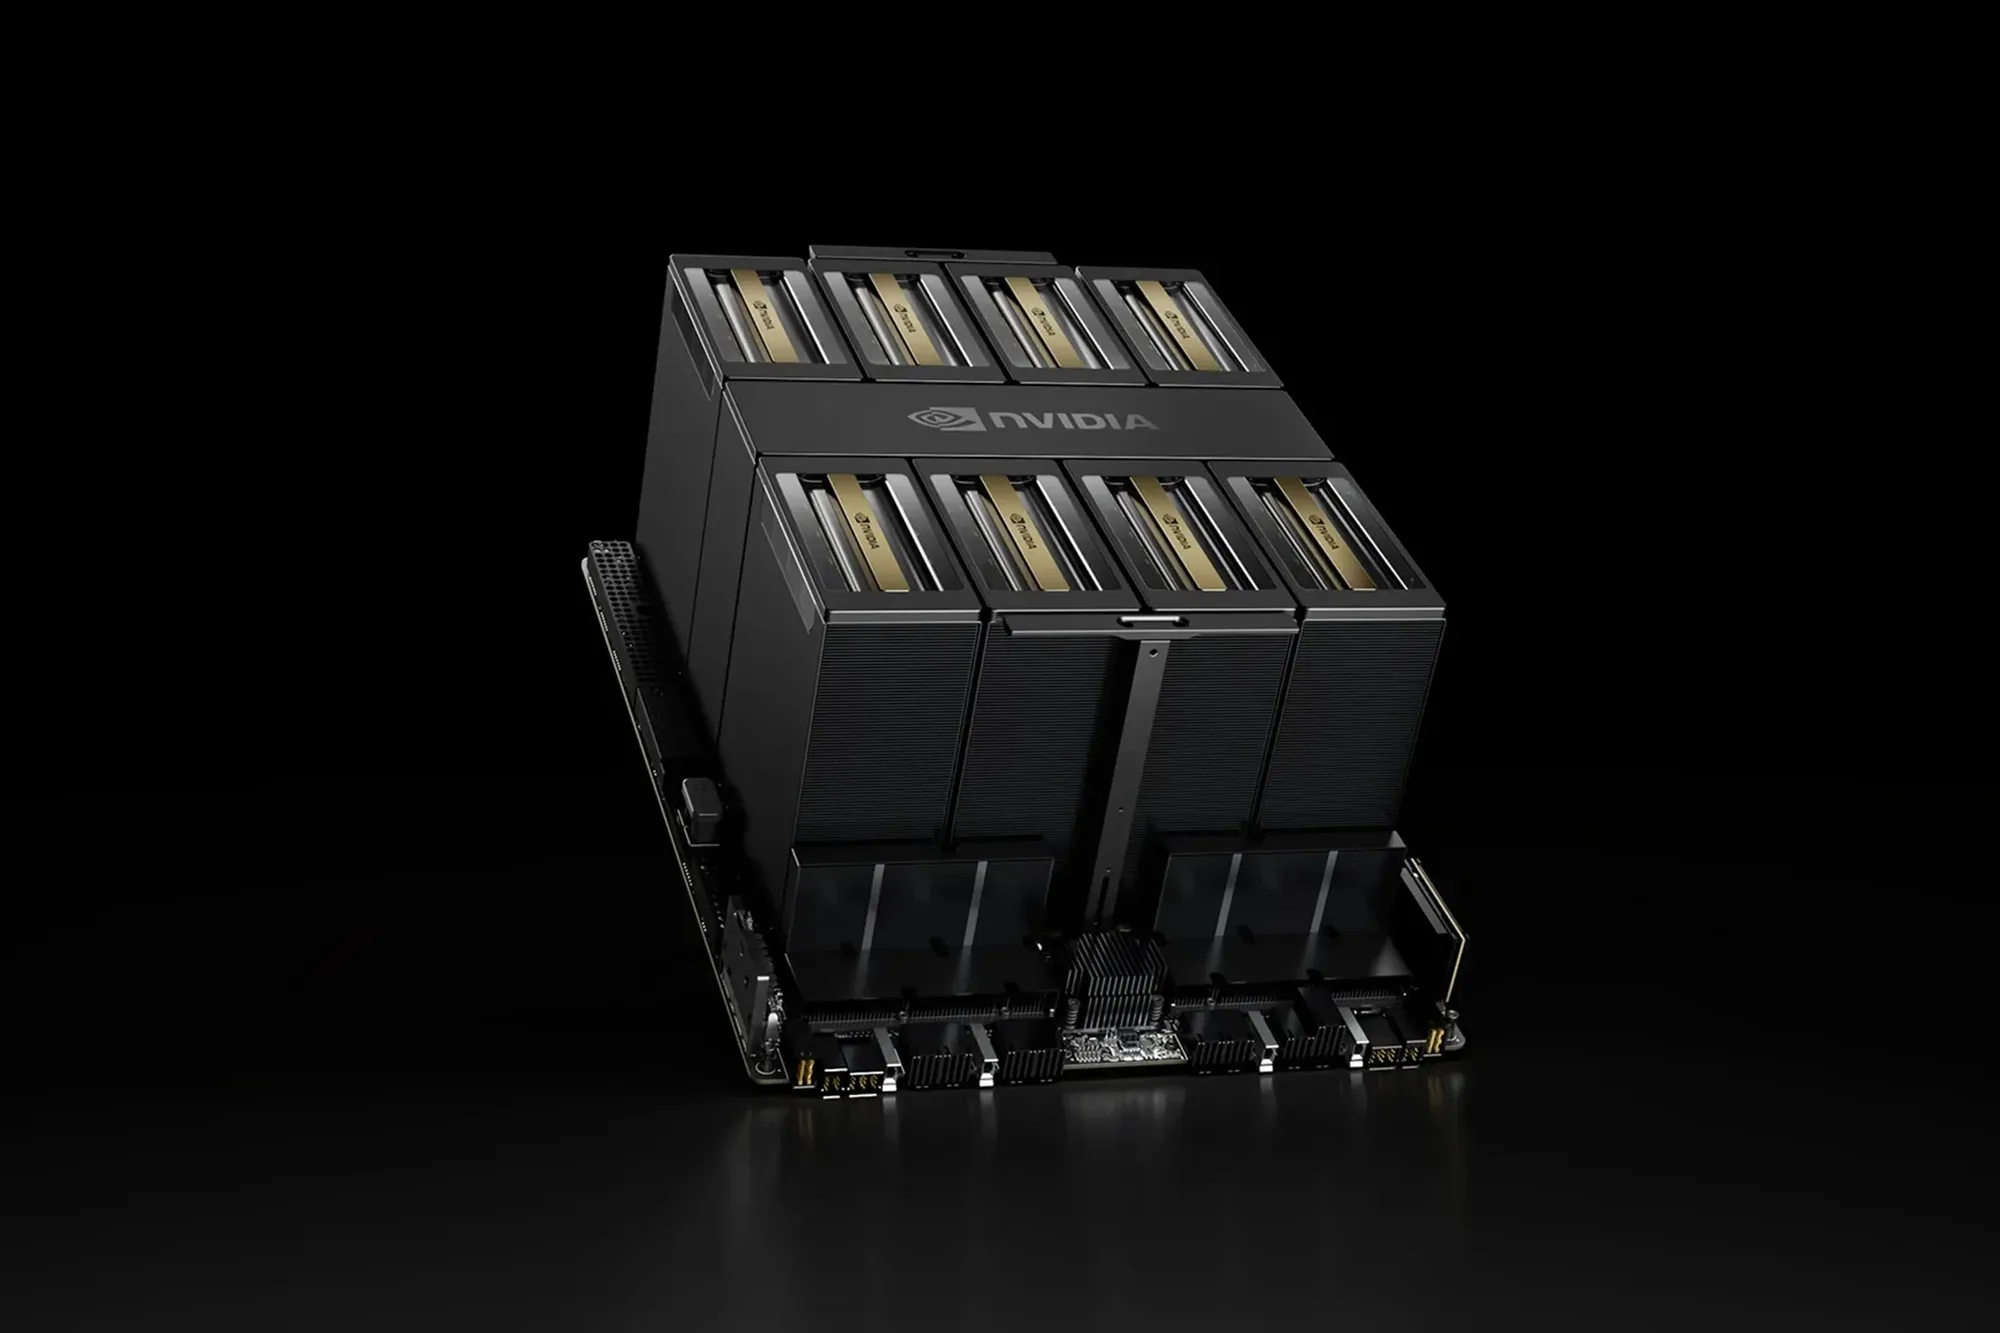
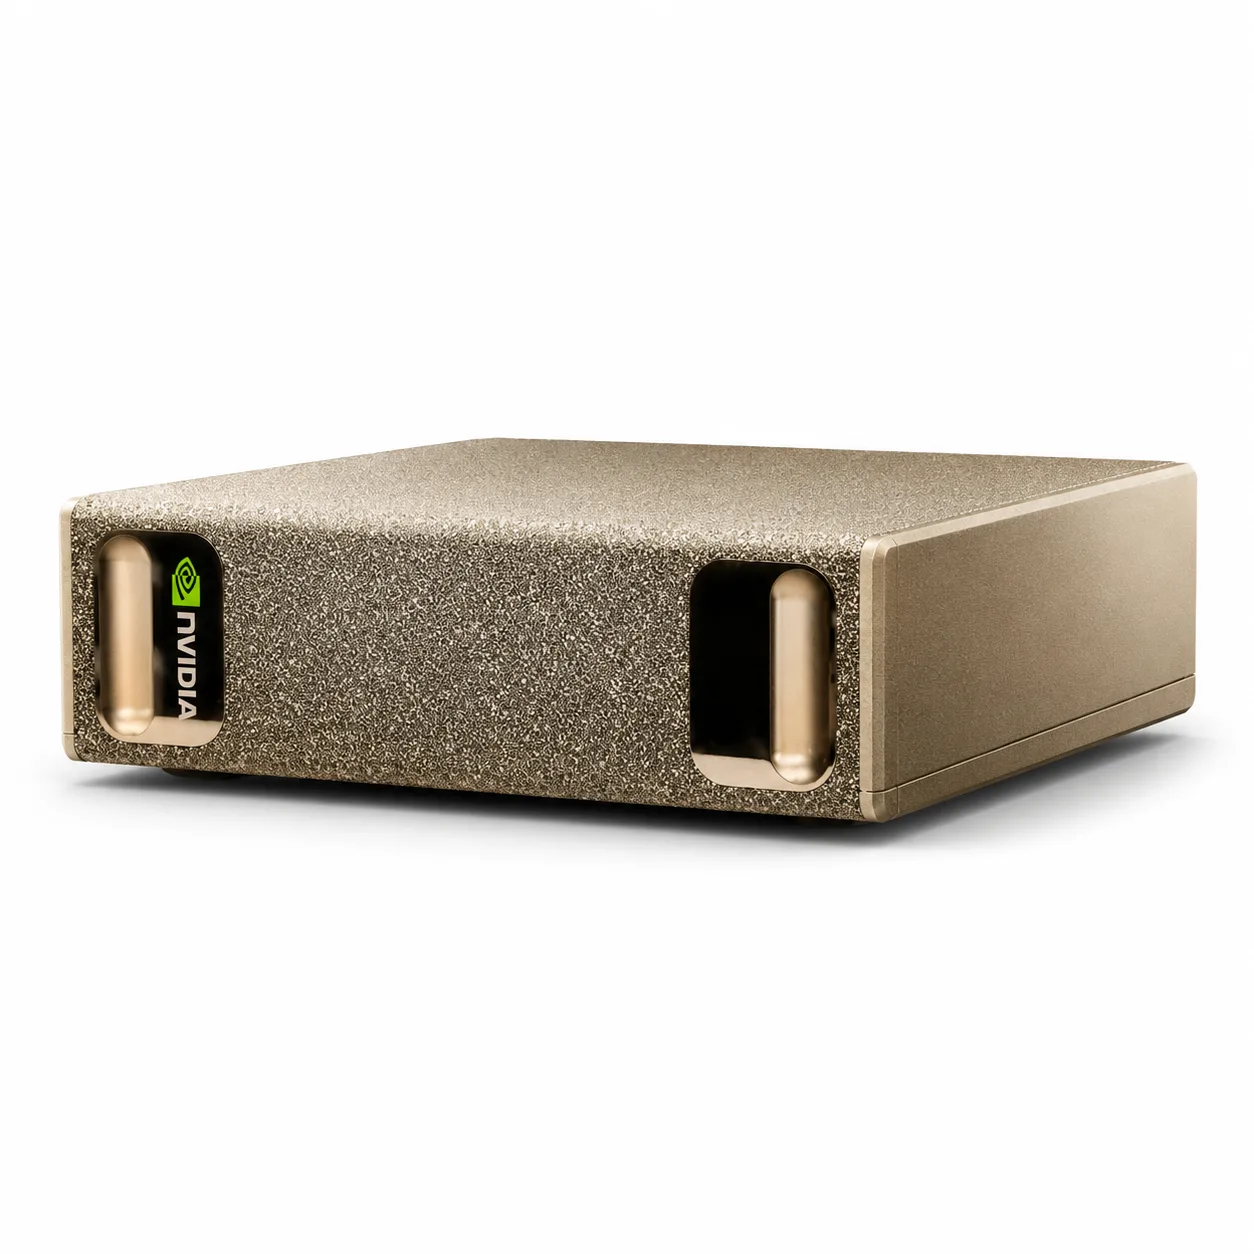
NVIDIA B300 Blackwell Ultra SXM6 288GB HBM3e نسل پیشرفته شتابدهندههای دیتاسنتری NVIDIA است که برای هوش مصنوعی استدلالی، Agentic AI، مدلهای زبانی عظیم، Generative AI، AI Inference و Training در مقیاس دیتاسنتر طراحی شده است.
B300 بر پایه معماری NVIDIA Blackwell Ultra ساخته شده و نسبت به نسل Blackwell، تمرکز بیشتری بر پردازش مدلهای Reasoning، Contextهای بسیار طولانی و اجرای همزمان تعداد بالایی از درخواستهای هوش مصنوعی دارد.
مهمترین ویژگی این GPU، حافظه عظیم 288 گیگابایت HBM3e با پهنای باند تا 8 ترابایت بر ثانیه است؛ مشخصاتی که B300 را برای مدلهای چندصد میلیارد و حتی زیرساختهای مدلهای تریلیون پارامتری به گزینهای فوقحرفهای تبدیل میکنند.
| معماری GPU | NVIDIA Blackwell Ultra |
| مدل | NVIDIA B300 |
| فرم فاکتور | SXM6 |
| حافظه GPU | 288GB HBM3e |
| پهنای باند حافظه | تا 8TB/s |
| Tensor Core | نسل پنجم NVIDIA Tensor Core |
| Streaming Multiprocessors | تا 160 SM در معماری Blackwell Ultra |
| Tensor Cores | تا 640 Tensor Core نسل پنجم |
| NVFP4 | تا حدود 15 PFLOPS Dense در معماری Blackwell Ultra |
| FP8 | تا حدود 5 PFLOPS Dense در معماری Blackwell Ultra |
| NVIDIA NVLink | NVLink نسل پنجم |
| پهنای باند NVLink | تا 1.8TB/s برای هر GPU |
| NV-HBI Die-to-Die | 10TB/s |
| حافظه Bus Width | 8,192-bit |
| HBM Configuration | هشت Stack حافظه 12-Hi HBM3e |
| توان GPU | حدود 1100 وات در NVIDIA B300 SXM6 AC |
| پلتفرمهای اصلی | NVIDIA HGX B300 / NVIDIA DGX B300 |
یکی از بزرگترین ارتقاهای NVIDIA B300 افزایش ظرفیت حافظه GPU به 288GB HBM3e است.
ظرفیت بالای حافظه به مدلهای بزرگ اجازه میدهد وزنهای مدل، KV Cache و دادههای پردازشی بیشتری را مستقیماً در حافظه سریع GPU نگهداری کنند.
این موضوع در مدلهای Reasoning، Long-Context LLM، Mixture-of-Experts و Agentic AI که حافظه زیادی مصرف میکنند اهمیت ویژهای دارد.
حافظه B300 علاوه بر ظرفیت بالا، پهنای باندی تا 8 ترابایت بر ثانیه ارائه میدهد.
این پهنای باند بالا باعث میشود Tensor Coreها بتوانند با سرعت بسیار زیادی به وزنهای مدل و دادههای موردنیاز دسترسی داشته باشند و گلوگاه حافظه در بسیاری از Workloadهای AI کاهش یابد.
Blackwell Ultra بهطور ویژه برای نسل جدید مدلهای هوش مصنوعی استدلالی توسعه یافته است.
مدلهای Reasoning هنگام پاسخدهی مقدار بسیار بیشتری Compute مصرف میکنند و ممکن است چندین مرحله داخلی برای رسیدن به پاسخ نهایی اجرا کنند.
B300 با حافظه بزرگ، Tensor Coreهای قدرتمند و شتابدهی پیشرفته Attention، برای این نوع Workloadها طراحی شده است.
NVIDIA در Blackwell Ultra بخش Attention را بهبود داده است و شتاب محاسبات Attention نسبت به نسل Blackwell میتواند تا 2 برابر افزایش پیدا کند.
این ارتقا مخصوصاً برای Contextهای بسیار طولانی، Agentic AI، مدلهای Reasoning و سرویسهای LLM پرترافیک اهمیت دارد.
نسل پنجم NVIDIA Tensor Core از فرمت NVFP4 پشتیبانی میکند.
FP4 امکان کاهش حجم دادههای محاسباتی و افزایش Throughput مدلهای سازگار را فراهم میکند و Blackwell Ultra برای دستیابی به عملکرد بسیار بالا در این Precision بهینه شده است.
معماری Blackwell Ultra میتواند تا حدود 15 PetaFLOPS توان Dense NVFP4 در سطح GPU ارائه کند.
ظرفیت 288GB حافظه باعث میشود B300 بتواند مدلهای بسیار بزرگتری را با وابستگی کمتر به Memory Offloading اجرا کند.
NVIDIA اعلام کرده Blackwell Ultra ظرفیت حافظه موردنیاز برای میزبانی مدلهای دارای بیش از 300 میلیارد پارامتر روی یک GPU را در سناریوهای مناسب فراهم میکند.
در پلتفرمهای چند GPU، B300 برای مدلهای بسیار بزرگتر، Mixture-of-Experts و مدلهای تریلیون پارامتری مقیاسپذیر است.
Agentهای هوش مصنوعی معمولاً نیازمند چندین مرحله Reasoning، فراخوانی ابزار، Context طولانی و پردازش همزمان تعداد زیادی درخواست هستند.
B300 با افزایش حافظه و قدرت Attention برای چنین محیطهایی طراحی شده و میتواند در AI Factoryهای سازمانی و Cloud AI مورد استفاده قرار گیرد.
NVIDIA B300 از NVLink نسل پنجم استفاده میکند.
پهنای باند GPU-to-GPU تا 1.8 ترابایت بر ثانیه امکان تبادل سریع داده میان GPUها را در سیستمهای چند GPU فراهم میکند.
این ویژگی برای Distributed Training، Tensor Parallelism و اجرای مدلهایی که میان چند GPU تقسیم شدهاند اهمیت بسیار زیادی دارد.
NVIDIA HGX B300 از 8 عدد NVIDIA Blackwell Ultra SXM GPU استفاده میکند.
هشت GPU با ظرفیت 288GB، مجموعاً حدود 2.3 ترابایت حافظه GPU در اختیار یک پلتفرم HGX B300 قرار میدهند و پهنای باند تجمعی حافظه تا حدود 64TB/s میرسد.
NVIDIA از همین Blackwell Ultra GPUها در سیستم DGX B300 استفاده میکند.
DGX B300 دارای هشت GPU Blackwell Ultra است و در سطح سیستم تا 144 PFLOPS توان FP4 Tensor Core ارائه میکند.
پهنای باند تجمعی NVLink در این سیستم به 14.4TB/s میرسد.
| مشخصات | NVIDIA B300 | NVIDIA B200 |
|---|---|---|
| معماری | Blackwell Ultra | Blackwell |
| حافظه GPU | 288GB HBM3e | تا 192GB HBM3e |
| پهنای باند حافظه | تا 8TB/s | تا 8TB/s |
| Attention Acceleration | تا 2 برابر Blackwell | نسل Blackwell |
| تمرکز اصلی | Reasoning & Agentic AI | Training & Inference |
NVIDIA B300 Blackwell Ultra دارای 288GB حافظه HBM3e برای هر GPU است.
پهنای باند حافظه Blackwell Ultra B300 تا 8TB/s برای هر GPU میرسد.
بله. حافظه 288GB HBM3e، Tensor Coreهای نسل پنجم، NVFP4 و شتابدهی پیشرفته Attention این GPU را برای LLM، Long-Context Models، Reasoning AI و Agentic AI بسیار مناسب میکنند.
B300 خود GPU مبتنی بر Blackwell Ultra است، در حالی که GB300 یک Grace Blackwell Ultra Superchip است که GPUهای Blackwell Ultra را با پردازنده NVIDIA Grace در یک معماری یکپارچه ترکیب میکند.
خیر. B300 یک GPU با فرم فاکتور SXM6 است و باید در پلتفرم سازگار نصب شود.
* عملکردهای Peak بسته به SKU، پلتفرم، Precision، حالت Dense/Sparse و تنظیمات توان متفاوت هستند. مشخصات نهایی سرور باید با پیکربندی OEM بررسی شود.
هنوز نظری برای این محصول ثبت نشده است.
هنوز سوالی برای این محصول ثبت نشده است.
شتابدهنده NVIDIA B300 Blackwell Ultra SXM6 288GB HBM3e