مقدمه: بررسی جامع معماری NVIDIA Blackwell
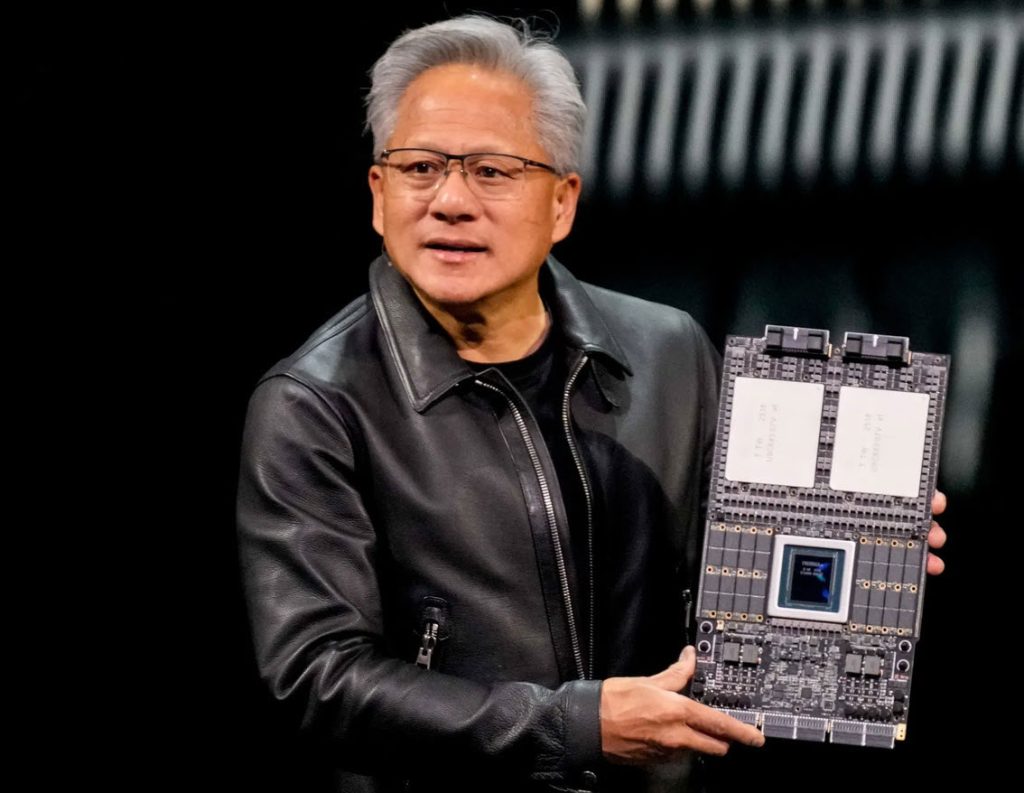 با رشد انفجاری مدلهای زبانی بزرگ (LLM)، هوش مصنوعی مولد (Generative AI) و سیستمهای خودمختار، نیاز به توان محاسباتی فراتر از استانداردهای گذشته به یکی از اصلیترین چالشهای دنیای فناوری تبدیل شده است. کمپانی انویدیا (NVIDIA) بهعنوان پیشگام پردازشهای گرافیکی و محاسبات سنگین هوش مصنوعی، با معرفی معماری NVIDIA Blackwell، فصل جدیدی را در صنعت نیمههادیها و ابرکامپیوترها آغاز کرد.
معماری بلک ول که به پاس گرامی داشت یاد دیوید هارولد بلکول (آماردان و ریاضیدان برجسته) نامگذاری شده، جانشین مستقیم معماری موفق Hopper است. این معماری نهتنها قدرت پردازش را به شکلی نمایی افزایش داده، بلکه الگوی مصرف انرژی و کارایی محاسباتی را در پردازشهای سنگین هوش مصنوعی بازتعریف کرده است. در این مقاله تخصصی، به بررسی عمیق ساختار ریزتراشهها، ویژگیهای فنی کلیدی، تفاوتها با نسل قبل و نقش این معماری در ابرکامپیوترهای رومیزی میپردازیم.
۱. ساختار تراشه و معماری ریزپردازنده (Chiplet Architecture)
یکی از مهمترین نوآوریهای معماری Blackwell، عبور از محدودیتهای فیزیکی تراشههای تکقالبی (Monolithic) و استفاده از ساختار چندقالبی یا چیپلت (Chiplet) است.
در فرآیند ساخت چیپستهای بلکول (مانند B200 و سوپرچیپ GB10)، از گره پردازشی سفارشیسازیشده 4N شرکت TSMC استفاده شده است. این تراشه از متصلسازی دو قالب سیلیکونی بزرگ ساخته شده که از طریق اتصالی فوقسریع با سرعت ۱۰ ترابایت بر ثانیه (10 TB/s) به یکدیگر متصل هستند. این دو قالب در عمل به عنوان یک تراشه کاملاً منسجم و یکپارچه عملکرد خود را ارائه میدهند.
آمار شگفتانگیز ترانزیستورها:
تراشههای مبتنی بر معماری Blackwell در پیکربندی کامل خود بالغ بر ۲۰۸ میلیارد ترانزیستور را در خود جای دادهاند. این میزان تراکم ترانزیستور، توان محاسباتی لازم برای آموزش و استنتاج مدلهای چندصد میلیاردی را فراهم میسازد.
۲. ویژگیهای کلیدی و فناوریهای ساختارشکن Blackwell
الف) هستههای تنسور نسل پنجم (5th Gen Tensor Cores)
هستههای تنسور در پردازندههای انویدیا مسوولیت مستقیم اجرای محاسبات ماتریسی هوش مصنوعی را بر عهده دارند. در معماری بلکول، نسل پنجم این هستهها معرفی شده است که با موتور جدید شتابدهنده دقتهای پایین همراه شدهاند.
ب) موتور مقیاسپذیری و پشتیبانی از دقت FP4
یکی از جهشهای بزرگ Blackwell، پشتیبانی نیتیو از دقت محاسباتی FP4 (ممیز شناور ۴ بیتی) است. تا پیش از این، محاسبات هوش مصنوعی عمدتاً روی FP16، BF16 یا FP8 انجام میشد. فناوری FP4 به توسعهدهندگان اجازه میدهد تا حجم حافظه مورد نیاز برای ذخیرهسازی وزنهای مدلهای زبانی را به نصف کاهش داده و سرعت استنتاج را به طور چشمگیری افزایش دهند.
ج) گذرگاه NVLink-C2C و NVLink نسل پنجم
ارتباط میان پردازنده مرکزی (CPU) و پردازنده گرافیکی (GPU) همواره یکی از گلوگاههای اصلی در پردازش دادهها بوده است. انویدیا در معماری Blackwell از فناوری NVLink-C2C (Chip-to-Chip) استفاده کرده است که پهنای باندی معادل ۱.۸ ترابایت بر ثانیه ارائه میدهد و ۵ برابر سریعتر از استاندارد PCIe Gen 5 است.
۳. مقایسه معماری Blackwell با نسل قبلی (Hopper)
برای درک بهتر جهش قدرتی این معماری، مقایسه مشخصات فنی بلکول با معماری موفق Hopper در جدول زیر خلاصه شده است:
| مشخصه فنی | معماری Hopper (H100) | معماری Blackwell (B200 / GB10) | میزان بهبود |
|---|---|---|---|
| تعداد ترانزیستورها | ۸۰ میلیارد | ۲۰۸ میلیارد | ۲.۶ برابر بیشتر |
| فناوری ساخت (Node) | TSMC 4N | TSMC 4N سفارشی | بهینهسازی چیپلت |
| توان محاسباتی AI | پشتیبانی نمیشود (FP4) | تا ۲۰ پتافلاپس / ۱ پتافلاپ در GB10 | جهش در دقت FP4 |
| پهنای باند NVLink | ۹۰۰ گیگابایت بر ثانیه | ۱.۸ ترابایت بر ثانیه | ۲ برابر سریعتر |
۴. موتور اطمینان و امنیت سختافزاری (DeRA & RAS Engine)
در پردازشهای سنگین سازمانی که روزها یا هفتهها به طول میانجامد، بروز خطا در یک بیت حافظه میتواند کل فرآیند آموزش مدل را خراب کند. انویدیا در معماری Blackwell یک موتور اختصاصی RAS (Reliability, Availability, and Serviceability) تعبیه کرده است. این موتور با استفاده از هوش مصنوعی پیشبینیکننده، سلامتی هستههای پردازشی را پایش کرده و در صورت بروز اختلال، دادهها را بدون توقف سیستم به هستههای پشتیبان منتقل میکند.
۵. بهینهسازی مصرف انرژی و بازدهی اکولوژیک (Green AI)
معماری Blackwell گامی بزرگ در جهت هوش مصنوعی سبز برداشته است. این معماری قادر است استنتاج مدلهای زبانی بزرگ را با ۲۵ برابر مصرف انرژی کمتر نسبت به نسل قبلی انجام دهد. همچنین به لطف استفاده از حافظههای کممصرف LPDDR5x در چیپستهای دسکتاپ (مانند GB10)، بالاترین نرخ بازدهی پردازش به ازای هر وات را به ثبت رسانده است.
۶. ورود معماری Blackwell به ابرکامپیوترهای رومیزی (Desktop AI)
تا پیش از معرفی سوپرچیپ NVIDIA GB10 Grace Blackwell، بهرهمندی از توان پتافلاپ نیازمند رکهای بزرگ دیتاسانتری بود. با ترکیب پردازنده ۲۰ هستهای Arm Grace و گرافیک Blackwell روی یک سوپرچیپ کوچک، امکان ساخت ابرکامپیوترهای رومیزی فراهم شد.
⭐ تجهیزات تخصصی مبتنی بر معماری Blackwell
- سوپر کامپیوتر هوش مصنوعی انویدیا DGX Spark – 128GB / 4TB مشاهده و خرید محصول ←
- سوپر کامپیوتر هوش مصنوعی ایسوس ASUS Ascent GX10 – 128GB / 1TB مشاهده و خرید محصول ←
- سوپر کامپیوتر هوش مصنوعی ایسوس ASUS Ascent GX10 – 128GB / 4TB مشاهده و خرید محصول ←
۷. سیستمعامل و اکوسیستم نرمافزاری بهینهشده
معماری سختافزاری Blackwell با NVIDIA AI Enterprise Software Stack و سیستمعامل NVIDIA DGX OS هماهنگ شده است. ابزارهایی مانند NVIDIA NIM (میکروسرویسها)، TensorRT-LLM و پشتیبانی نیتیو از فریمورکهای PyTorch، Jupyter و Ollama روی این بستر به صورت محلی اجرا میشوند.
جمعبندی: چرا معماری Blackwell آینده هوش مصنوعی است؟
معماری NVIDIA Blackwell فراتر از یک ارتقای سختافزاری ساده است؛ این معماری یک نقطهعطف در صنعت محاسبات هوشمند محسوب میشود. تلفیق فناوری چیپلت، پشتیبانی از دقت FP4، ارتباط پرسرعت NVLink-C2C و ارائه توان ۱ پتافلاپ در ابعاد رومیزی، مسیر را برای توسعهدهندگان هموار کرده است. اگر قصد دارید بدون وابستگی به زیرساختهای ابری گرانقیمت، مدلهای پیشرفته هوش مصنوعی را بهصورت محلی اجرا کنید، محصولات مبتنی بر معماری GB10 Grace Blackwell بهترین انتخاب هستند.
📌 منابع و مستندات رسمی مقاله (NVIDIA Blackwell Architecture):