کارت گرافیک هوش مصنوعی چیست؟
راهنمای جامع انتخاب و خرید AI GPU تخصصی
با یکی دیگر از مقالات سایت سدید گستران با عنوان “راهنمای خرید کارت گرافیک هوش مصنوعی AI GPU” در خدمت شما هستیم . در عصر انفجار فناوری هوش مصنوعی و شبکههای عصبی عمیق، واحد پردازش گرافیکی (GPU) از یک قطعه رندرینگ تصویری ساده به شریان اصلی و قلب تپنده پردازشهای محاسباتی تبدیل شده است. از آموزش مدلهای بزرگ زبانی (LLM) نظیر GPT و Llama گرفته تا پردازش بینایی ماشین، تولید تصویر و سیستمهای خودران، همگی نیازمند قدرت پردازش موازی خشن و پهنای باند حافظه فوقالعادهای هستند که تنها توسط یک کارت گرافیک هوش مصنوعی تخصصی تامین میشود.
انتخاب اشتباه GPU در پروژههای هوش مصنوعی میتواند به قیمت بروز گلوگاههای شدید در بارگذاری مدلها، خطای کمبود حافظه (Out of Memory)، کندی چند برابری در زمان آموزش (Training Time) و اتلاف سنگین سرمایهگذاری منجر شود. در این مقاله جامع از “سدید گستران“، به بررسی معماری، فاکتورهای حیاتی انتخاب، مقایسه دقیق مدلهای پرچمدار و نکات کلیدی خرید کارت گرافیک AI میپردازیم. جهت بررسی زیرساختهای کلانتر نیز میتوانید به مقاله مرجع راهنمای جامع خرید تجهیزات هوش مصنوعی مراجعه فرمایید.
چرا پردازنده های گرافیکی (GPU) برای هوش مصنوعی ضروری هستند؟
برای درک اهمیت کارت گرافیک هوش مصنوعی، باید تفاوت ساختاری CPU و GPU را در نحوه اجرای دستورالعملها بررسی کرد. پردازنده مرکزی (CPU) دارای تعداد محدودی هسته پردازشی بسیار قدرتمند است که برای اجرای دستورات پیچیده بهصورت متوالی و خطی طراحی شدهاند. در مقابل، الگوریتمهای هوش مصنوعی و شبکههای عصبی عمیق (Deep Neural Networks) شامل میلیونها یا میلیاردها پارامتر و ضرب ماتریسی هستند که نیازمند اجرای همزمان محاسبات میباشند.
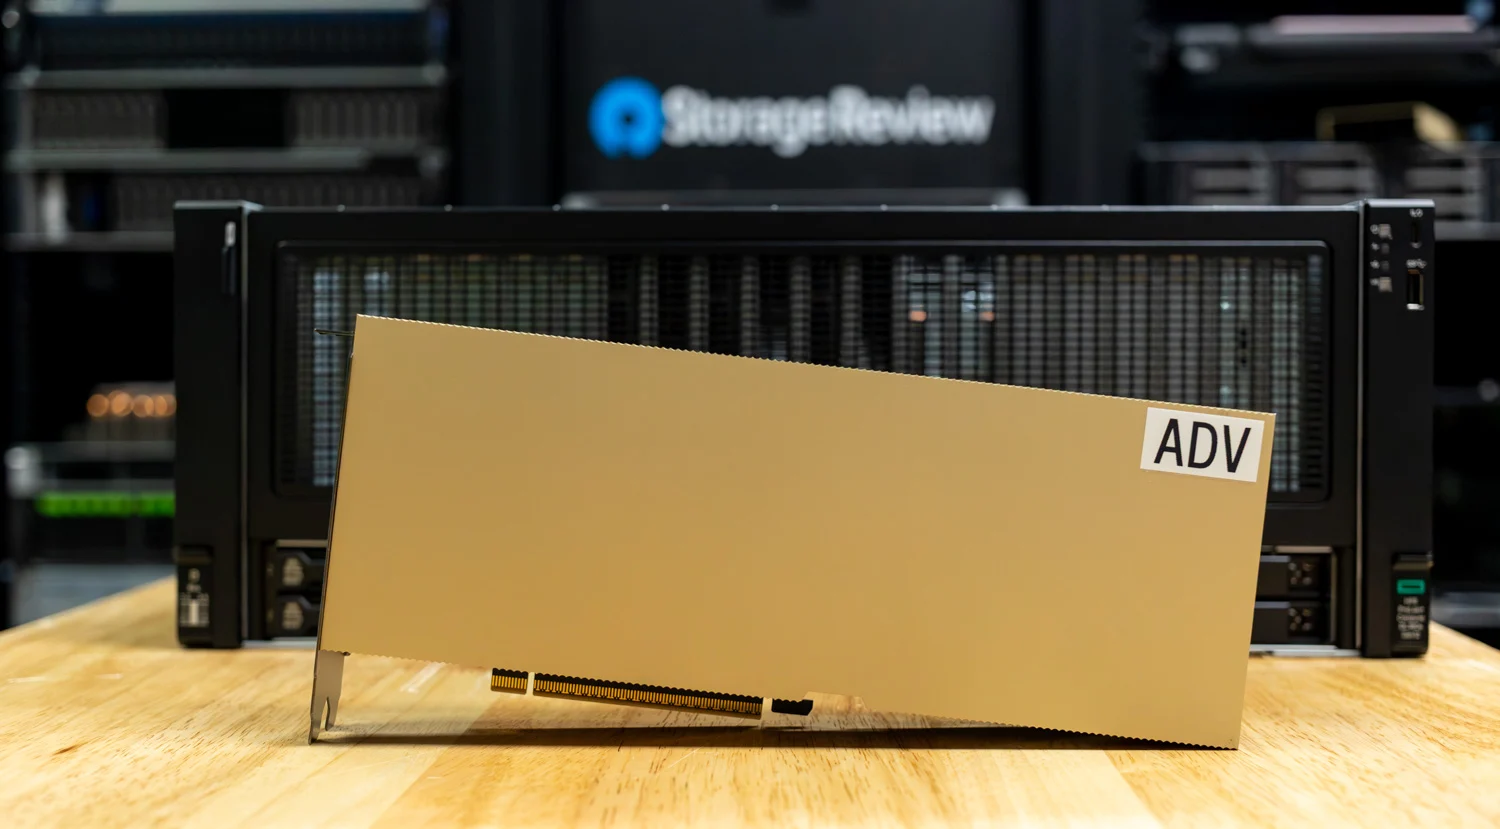
یک AI GPU با بهرهگیری از هزاران هسته پردازشی کوچکتر (CUDA Cores) و هستههای تخصصی هوش مصنوعی (Tensor Cores)، میتواند میلیونها محاسبه ریاضی اعشاری را بهطور همزمان و موازی (Parallel Processing) پردازش کند. این معماری زمان آموزش مدلهای هوش مصنوعی را از چند ماه روی CPU، به چند روز یا چند ساعت کاهش میدهد.
معیارها و فاکتورهای حیاتی در خرید کارت گرافیک هوش مصنوعی
هنگام ارزیابی و انتخاب یک کارت گرافیک هوش مصنوعی، اتکا به معیارهای متداول گیمینگ مانند تعداد FPS به هیچ عنوان پاسخگو نیست. باید فاکتورهای زیر را کاملاً دقیق تحلیل کنید:
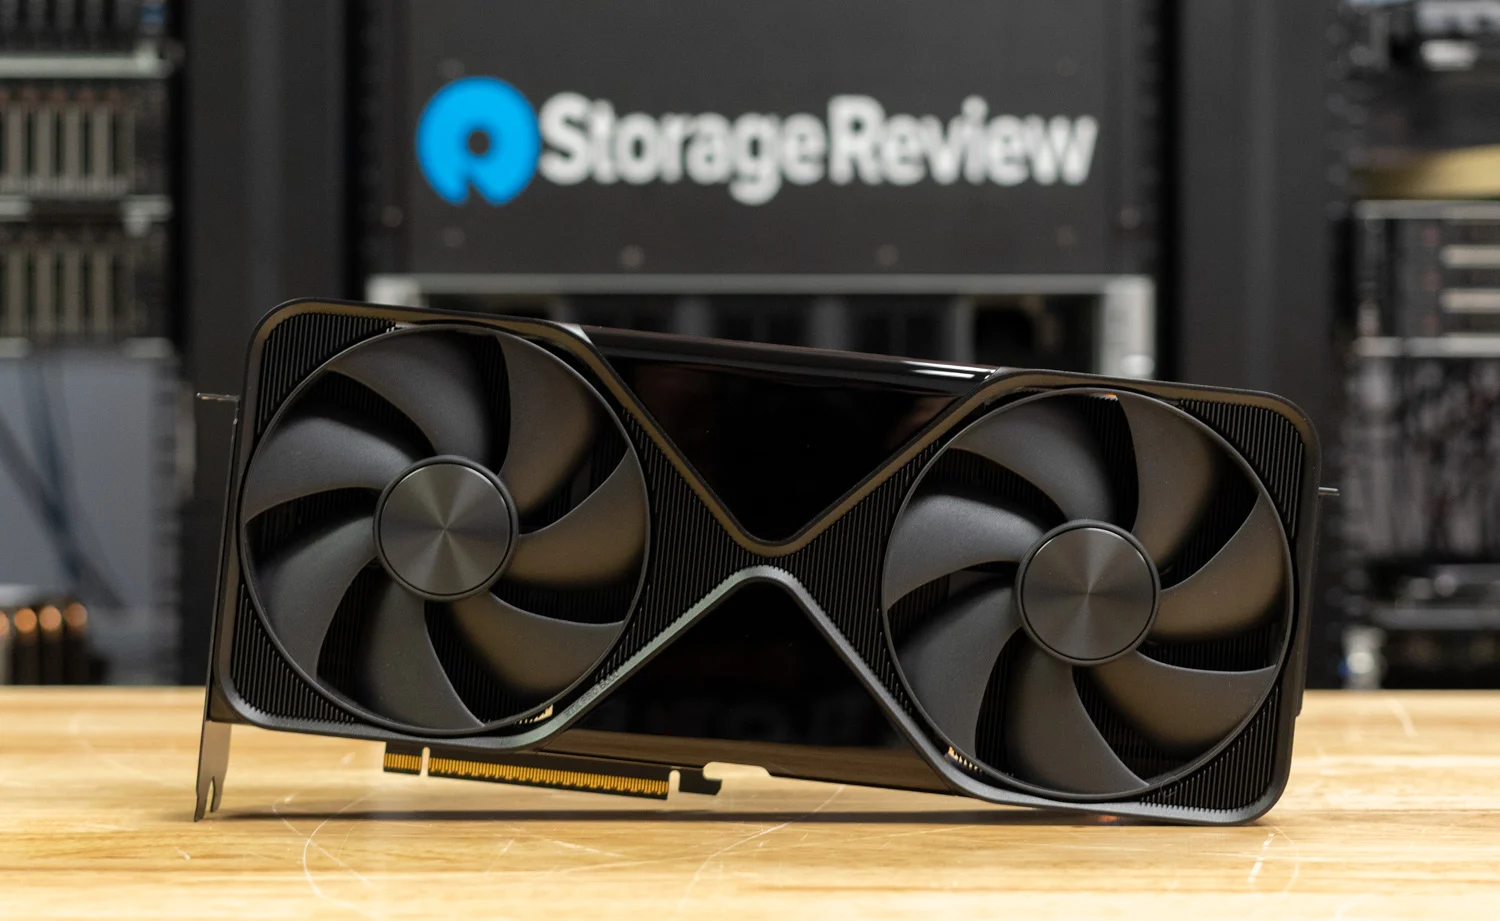
۱. ظرفیت حافظه ویدیویی (VRAM)
ظرفیت VRAM مستقیماً تعیین میکند چه سایزی از مدل هوش مصنوعی میتواند به صورت کامل روی کارت بارگذاری شود. به عنوان مثال، برای اجرای یک مدل زبانی ۷۰ میلیارد پارامتری (70B) با کوانتایز ۴ بیتی، حداقل به ۴۰ گیگابایت حافظه VRAM نیاز دارید. اگر مدل در VRAM جا نشود، امکان اجرای آن یا کلاً از بین میرود یا سیستم مجبور به استفاده از رم اصلی و کند شدن ۱۰۰ برابری خواهد شد.
۲. پهنای باند حافظه (Memory Bandwidth)
در فاز استنتاج (Inference) مدلهای زبانی بزرگ، پهنای باند حافظه کلیدیترین فاکتور در سرعت تولید توکن بر ثانیه است. کارتهای گرافیک حرفهای از حافظههای نسل جدید GDDR6X یا حافظههای دیتاسنتری فوقسریع HBM2e / HBM3 بهره میبرند که پهنای باندی بین ۱ تا ۳.۳ ترابایت بر ثانیه فراهم میکنند.
۳. هستههای اختصاصی Tensor و دقتهای محاسباتی
هستههای Tensor واحدهای سختافزاری ویژهای در گرافیکهای انویدیا هستند که شتابدهی به محاسبات ضرب ماتریسی (GEMM) را بر عهده دارند. این هستهها از دقتهای عددی مختلف پشتیبانی میکنند:
- FP32 (ممیز شناور ۳۲ بیتی): دقت بسیار بالا، مناسب برای محاسبات علمی دقیق اما سنگین.
- FP16 و BF16 (ممیز شناور ۱۶ بیتی): استاندارد اصلی برای آموزش (Training) مدلهای یادگیری عمیق.
- INT8 و FP4 (۸ بیتی و ۴ بیتی): عالی برای کوانتایز کردن و استنتاج (Inference) فوقالعاده سریع با کمترین مصرف حافظه.
💡 نکته تخصصی سدید گستران: پشتیبانی نسل چهارم و پنجم هستههای Tensor از فرمتهای FP8 و FP4 سرعت اجرای مدلهای زبانی جدید را بدون افت چشمگیر دقت، تا ۴ برابر افزایش میدهد.
۴. پشتیبانی از تکنولوژیهای اتصال Multi-GPU (NVLink)
اگر قصد دارید چندین کارت گرافیک را کنار یکدیگر قرار دهید، استفاده از گذرگاه معمولی PCIe ممکن است باعث گلوگاه شود. کارتهای دیتاسنتری انویدیا از فناوری NVIDIA NVLink پشتیبانی میکنند که ارتباط مستقیم بین GPUها را با سرعت ۹۰۰ گیگابایت تا ۱.۸ ترابایت بر ثانیه امکانپذیر میسازد.
مقایسه کارتهای گرافیک ورك استیشن و دیتا سنتری
کارتهای گرافیک هوش مصنوعی در دو کلاس اصلی به بازار عرضه میشوند. انتخاب بین این دو کلاس، مستقیم به نوع پروژه و محل نصب بستگی دارد:
 بررسی زیرساخت برق و خنککنندگی برای نصب GPU
 بررسی زیرساخت برق و خنککنندگی برای نصب GPU
کارتهای گرافیک هوش مصنوعی مدرن، مصرف برق و تولید حرارت فوقالعاده بالایی دارند. پیش از ثبت سفارش حتماً موارد زیر را چک کنید:
- توان منبع تغذیه (Power Supply): کارتهایی نظیر RTX 4090 به تنهایی ۴۵۰ تا ۶۰۰ وات برق مصرف میکنند. برای سیستمی با دو کارت گرافیک سنگین، پاور حداقل ۱۶00 تا ۲۰00 وات استاندار به شدت ضروری است.
- تهویه شاسی و تهویه محیط: دمای بالای ۸۵ درجه سانتیگراد در پردازشهای طولانی باعث کاهش خودکار فرکانس (Thermal Throttling) و سقوط کارایی میشود. استفاده از کیسهای استاندارد با airflow مستقیم یا شاسیهای اختصاصی سرور هوش مصنوعی الزامآور است.
سیستمهای هوش مصنوعی آماده؛ راهکاری بدون چالش اسمبل
اگر مایل نیستید زمان و انرژی خود را صرف انتخاب جداگانه مادربورد، پاور پرقدرت، کیس و کولینگ برای کارت گرافیک کنید، تهیه سیستمهای هوش مصنوعی آماده بهترین گزینه است. در این سیستمها تمام قطعات و کارتهای گرافیک بهصورت کارخانهای با هم کالیبره شدهاند و دارای پایداری ۱۰۰ درصدی هستند.
پرسشهای متداول (FAQ)
۱. آیا استفاده از دو کارت گرافیک ضعیفتر بهتر از یک کارت گرافیک قوی است؟
در استنتاج مدلهای زبانی بزرگ، جمع شدن ظرفیت VRAM دو کارت برای بارگذاری مدل مفید است؛ اما برای آموزش و سرعت پردازش، یک کارت قویتر با پهنای باند بالاتر معمولاً کارایی و پایداری بسیار بهتری بدون پیچیدگیهای نرمافزاری ارائه میدهد.
۲. اکوسیستم CUDA در کارتهای انویدیا چه مزیتی ایجاد میکند؟
CUDA بستر نرمافزاری اختصاصی انویدیا است که تقریباً تمام کتابخانهها و فریمورکهای استاندارد یادگیری ماشین (مثل PyTorch, TensorFlow, vLLM, TensorRT) روی آن بهینهسازی شدهاند. به همین دلیل کارتهای انویدیا انتخاب اول صنعت هوش مصنوعی هستند.
۳. چرا حافظه ECC در کارتهای دیتاسنتری هوش مصنوعی اهمیت دارد؟
حافظه ECC (Error-Correcting Code) خطاهای تکبیتی ناشی از تداخلات الکتریکی را در حین محاسبه شناسایی و اصلاح میکند و از خرابی ناگهانی پروژه یا نادرست شدن دادهها در آموزشهای چندهفتهای جلوگیری میکند.
جمعبندی و راهنمای خرید (راهنمای خرید کارت گرافیک هوش مصنوعی AI GPU)
خرید کارت گرافیک هوش مصنوعی حیاتیترین گام در احداث و توسعه زیرساختهای پردازشی است. بررسی دقیق نیاز پروژه، ابعاد مدل و نرخ پهنای باند، اصلیترین کلیدهای موفقیت شما خواهند بود. کارشناسان سدید گستران آماده ارائه مشاوره فنی تخصصی و تامین انواع AI GPUهای اصلی با ضمانت اصالت کالا به سازمانها و شرکتهای دانشبنیان میباشند.
مستندات رسمی و سایتهای مرجع (References)
- NVIDIA Tensor Core & AI GPU Architecture Documentation: https://www.nvidia.com/en-us/data-center/tensor-cores/
مرجع رسمی فنی انویدیا درباره معماری هستههای Tensor و کارایی شتابدهندههای هوش مصنوعی. - NVIDIA Hopper Architecture In-Depth Whitepaper: https://resources.nvidia.com/en-us-tensor-core
مستندات سفید معماری Hopper و شتابدهنده H100 در پردازشهای عمیق. - PyTorch CUDA Performance & Memory Optimization Guide: https://pytorch.org/docs/stable/notes/cuda.html
راهنمای رسمی بهینهسازی حافظه VRAM و هستههای پردازشی در فریمورک PyTorch.